Meine private KI-Box: Hermes Desktop auf einem GB10
Das Ziel: richtig gute KI daheim, die funktioniert wie jede App. Schnelles und langsames Denken, Bilder und Hermes Desktop auf einer GB10-Box, mit echten Zahlen.
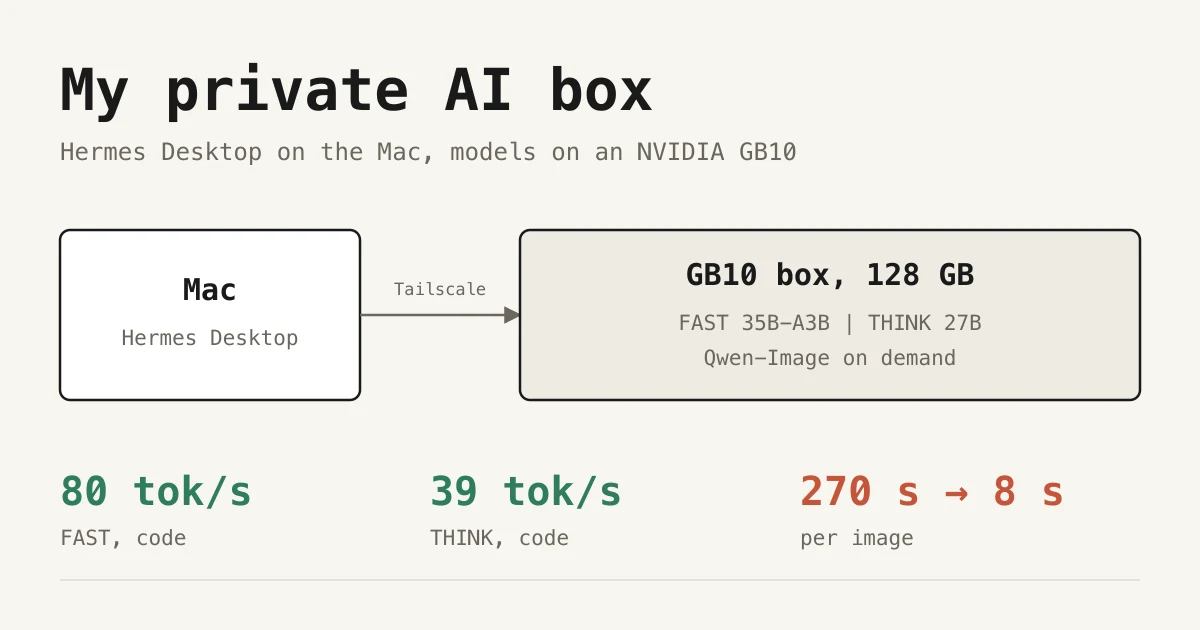
Das Ziel war schnell gesagt und schwer gebaut: richtig gute KI daheim, die funktioniert wie alles andere auch. App aufmachen, "Schnell" oder "Nachdenken" wählen, tippen, ein Foto anhängen, ein Bild anfordern. Kein Terminal, keine Modelldateien, kein "auf welchem Port war das nochmal". So wie sich ChatGPT oder Claude anfühlen. Nur läuft alles auf einer Box im Haus, und nichts verlässt sie.
Seit Mitte September ist das ein NVIDIA GB10 (DGX-Spark-Klasse, 128 GB Unified Memory), rund um die Uhr in Betrieb. Eine Box für alles:
- Schnelles Denken für den Alltag, rund 65 Token pro Sekunde
- Langsames Denken, wenn eine Antwort sorgfältig sein muss statt schnell
- Bilder generieren und bearbeiten, Entwürfe in etwa 8 Sekunden
- Sehen und Sprache: Foto reinziehen oder reden statt tippen
Die Oberfläche ist Hermes Desktop von Nous Research: eine richtige Mac-App mit Modellauswahl (Schnell / Nachdenken), Chatverlauf, Datei- und Bildanhängen, Plugins und Freigaben. Gleichzeitig ist sie ein Agent, der mit meinen Dateien, dem Terminal, dem Web und meinem CRM arbeitet. Im Alltag fühlt sich das nicht nach Self-Hosting an. Es fühlt sich an wie eine App.
Für Unternehmen in Österreich und Deutschland ist das mehr als ein Hobby: Wenn die Modelle im eigenen Haus laufen, stellt sich die Frage nach Auftragsverarbeitung in einer US-Cloud gar nicht erst.
In diesem Beitrag: wie es aufgebaut ist, was ich gemessen habe, welches Tuning sich gelohnt hat, was ich verworfen habe und wo es noch hakt.
Der Aufbau auf einen Blick
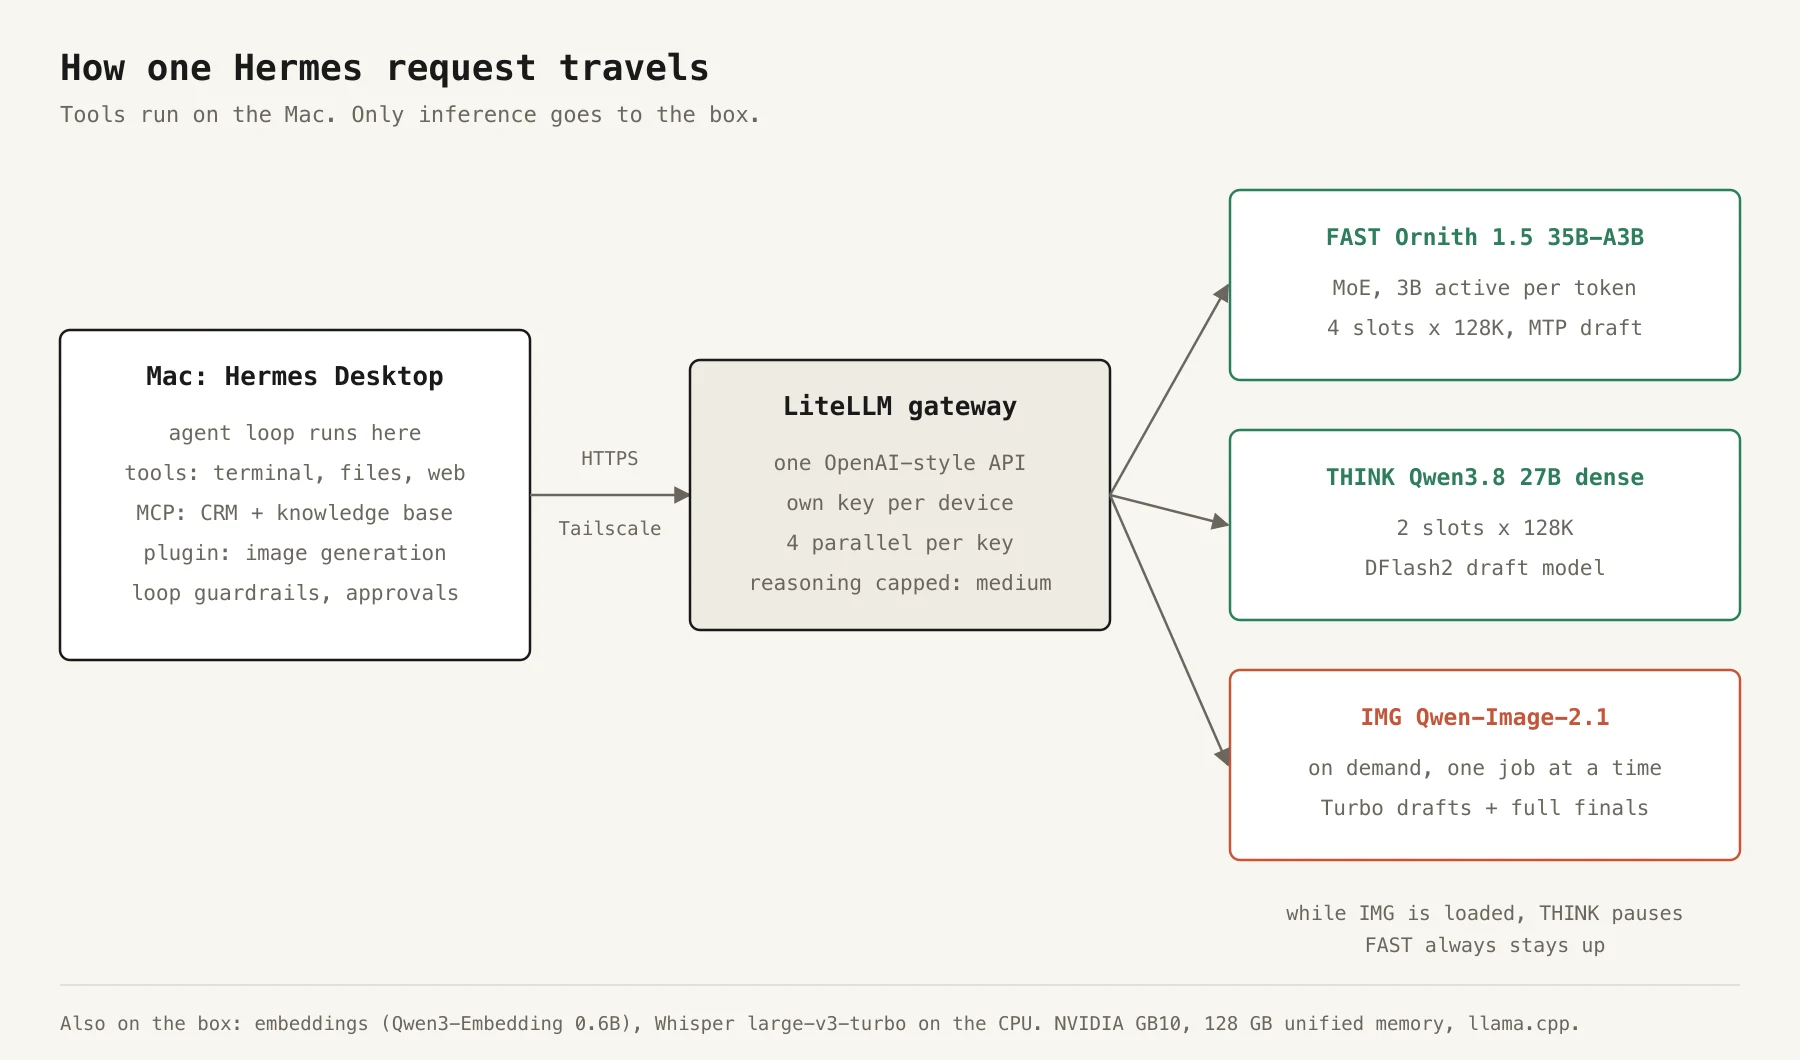 Wie eine Hermes-Anfrage vom Mac zur GB10-Box läuft
Die Aufteilung ist entscheidend: Hermes führt die Agent-Schleife und alle Tools auf dem Mac aus. Terminal-Befehle, Dateiänderungen, Webseiten lesen und die MCP-Verbindungen zu CRM und Wissensdatenbank laufen lokal. Nur die Inferenz geht übers Netz, über Tailscale und HTTPS, zur Box.
Auf der Box ist alles dauerhaft geladen, außer dem Bildmodell:
| Rolle | Modell | Setup |
|---|---|---|
| FAST | Ornith 1.5 35B-A3B (Mixture of Experts, 3B aktiv pro Token) | Q4, 4 Slots × 128K Kontext, eingebautes MTP |
| THINK | Qwen3.8 27B (dense) | Q4, 2 Slots × 128K Kontext, DFlash2-Draft-Modell |
| EMBED | Qwen3-Embedding 0.6B | Q8 |
| SPEECH | Whisper large-v3-turbo | int8, auf der CPU |
| IMG | Qwen-Image-2.1 und 2.1-Turbo | BF16, bei Bedarf geladen, ein Job nach dem anderen |
Die Chat-Modelle laufen nativ in llama.cpp, auf einen exakten Commit gepinnt. Davor sitzt ein LiteLLM-Gateway: ein OpenAI-kompatibler Endpunkt, ein eigener Schlüssel pro Gerät, maximal vier parallele Anfragen pro Schlüssel, Reasoning auf medium begrenzt. FAST ist der Standard für alles. Auf THINK schalte ich, wenn es sorgfältig sein soll statt schnell.
Die Hermes-Konfiguration, auf die es ankommt
Das meiste in Hermes bleibt auf Standard. Diese Teile haben den Unterschied gemacht:
model:
  default: box/fast
  provider: custom:box-inference
  context_length: 131072

providers:
  box-inference:          # darf NICHT "box" heißen
    api: https://<deine-box>/api/llm/v1
    key_env: BOX_HERMES_API_KEY
    transport: chat_completions

auxiliary:                # Titel, Komprimierung, Freigaben laufen auch auf der Box
  compression: { provider: custom:box-inference, model: box/fast, reasoning_effort: none }

tool_loop_guardrails:
  hard_stop_enabled: true
  hard_stop_after: { exact_failure: 5, same_tool_failure: 8, idempotent_no_progress: 5 }
Drei Punkte haben mich Zeit gekostet:
- Der Provider-Name. Mein erster Provider hieß
box, die Modelle heißenbox/fastundbox/think. Hermes hat das Präfixbox/als Providernamen gelesen und abgeschnitten, also fragte jede Anfrage nach einem Modell, das es nicht gibt. Umbenennen aufbox-inferencehat es gelöst. - Hilfsaufgaben. Hermes nutzt ein Modell für Chat-Titel, Kontext-Komprimierung und die Einstufung von Freigaben. Wenn du die nicht auch auf die Box zeigst, gehen sie still an den konfigurierten Cloud-Standard. Genau das will man bei einer privaten KI nicht.
- Lesen und Schreiben als getrennte Verbindungen. Der MCP-Server meines CRM markiert nicht, welche Tools nur lesen. Also hat jede Firma zwei Einträge: einen mit einer Allowlist aus 15 Lese-Tools und einen mit den 15 Schreib-Tools auf
trust: untrusted. Hermes fragt vor jeder Änderung. Getestet mit einer simulierten Ablehnung: Der Schreibzugriff wurde gestoppt, bevor eine Anfrage den Mac verlassen hat.
Was das Tuning gebracht hat
Alle Zahlen stammen von meiner Box, mit festen Prompts, Temperatur 0 und fixer Ausgabelänge, damit vorher und nachher vergleichbar sind. Sie gelten für die jeweilige Arbeitslast, nicht als allgemeiner Beschleunigungsfaktor.
FAST: Multi-Token-Prediction
Das FAST-Modell hat einen eingebauten Vorhersagekopf (MTP), der das nächste Token rät, das das Modell dann nur noch bestätigen muss. Mit einem vorgeschlagenen Token:
| Arbeitslast | Vorher | Nachher |
|---|---|---|
| Deutscher Fließtext | 66,4 tok/s | 64,9 tok/s |
| Neuer Python-Code | 65,9 tok/s | 80,1 tok/s |
| Code-Änderung mit viel Kopieren | 64,4 tok/s | 81,0 tok/s |
Text bleibt gleich schnell, Code wird rund 22 % schneller. Aggressivere Einstellungen sahen auf dem Papier besser aus. Ein separates DFlash-Draft-Modell schaffte 105 tok/s bei Code, aber nur noch 44 tok/s bei Text. MTP plus N-Gramm-Wiederverwendung kam bei Code-Änderungen auf 278 tok/s, wiederholte im Stresstest aber in 12 von 48 Anfragen einen Ein-Wort-Tippfehler (die Basis in 2 von 48). Beides ist nicht in Produktion gegangen.
THINK: ein Draft-Modell
Beim dichten 27B-Modell zahlt sich spekulatives Decoding richtig aus. Ein kleines DFlash2-Draft-Modell schlägt sieben Token auf einmal vor, THINK prüft sie in einem Durchgang:
| Arbeitslast | Vorher | Nachher |
|---|---|---|
| Deutscher Fließtext | 10,2 tok/s | 15,3 tok/s |
| Python-Code | 10,1 tok/s | 39,4 tok/s |
Fast 4× bei Code. Die Zahlen stammen vom Checkpoint, den ich im September verwendet habe. Der aktuelle landet im selben Bereich (16 tok/s Text, 38 tok/s Code). Ein paar Erkenntnisse nebenbei:
- Wer 15 Draft-Token anfordert, bekommt 7. Der Drafter wurde auf 8er-Blöcken trainiert, die Runtime begrenzt das stillschweigend.
- Der Q8-Drafter war langsamer als Q4.
- THINK läuft mit zwei statt vier Slots, damit später genug Speicher fürs Bildmodell bleibt.
Langer Kontext: schneller, ohne ein einziges Byte zu ändern
Bei rund 65K Token Kontext wird das Decoding langsamer, weil der Cache bei jedem Prüfschritt umgerechnet werden muss. Eine private Cache-Optimierung behält die ursprünglichen Q8-gerundeten Werte, speichert sie aber in FP16, sodass die Attention sie direkt lesen kann. Kostet 7,5 GiB extra und bringt +23 % bei 65K (deutscher Text 11,6 → 14,4 tok/s, Code 31,5 → 38,7 tok/s).
Warum ich ihr vertraue: Jede Vergleichsausgabe ist byte-identisch mit vorher, inklusive Reasoning-Text, generiertem Code und Agent-Replays. Die einfachere Variante, ein reiner FP16-Cache, war genauso schnell. Sie hat aber eine generierte Zahlungsabgleich-Funktion so verändert, dass doppelte Zahlungen komplett verworfen wurden. Das reichte, um sie zu verwerfen. Ein Speed-Trick, der die Ausgabe verändert, gehört gemessen wie ein Modellwechsel, nicht wie eine Beschleunigung.
Was das nicht löst: Ein kalter 65K-Prompt braucht weiterhin rund zwei Minuten bis zum ersten Token.
SGLang und vLLM mit NVFP4 habe ich auch probiert. Einzelne kurze Läufe waren schneller, aber entweder passten keine zwei vollen 128K-Slots in den Speicher, oder die Tests auf strukturierte Ausgaben fielen von 8/8 auf 6/8.
Bilder: von viereinhalb Minuten auf acht Sekunden
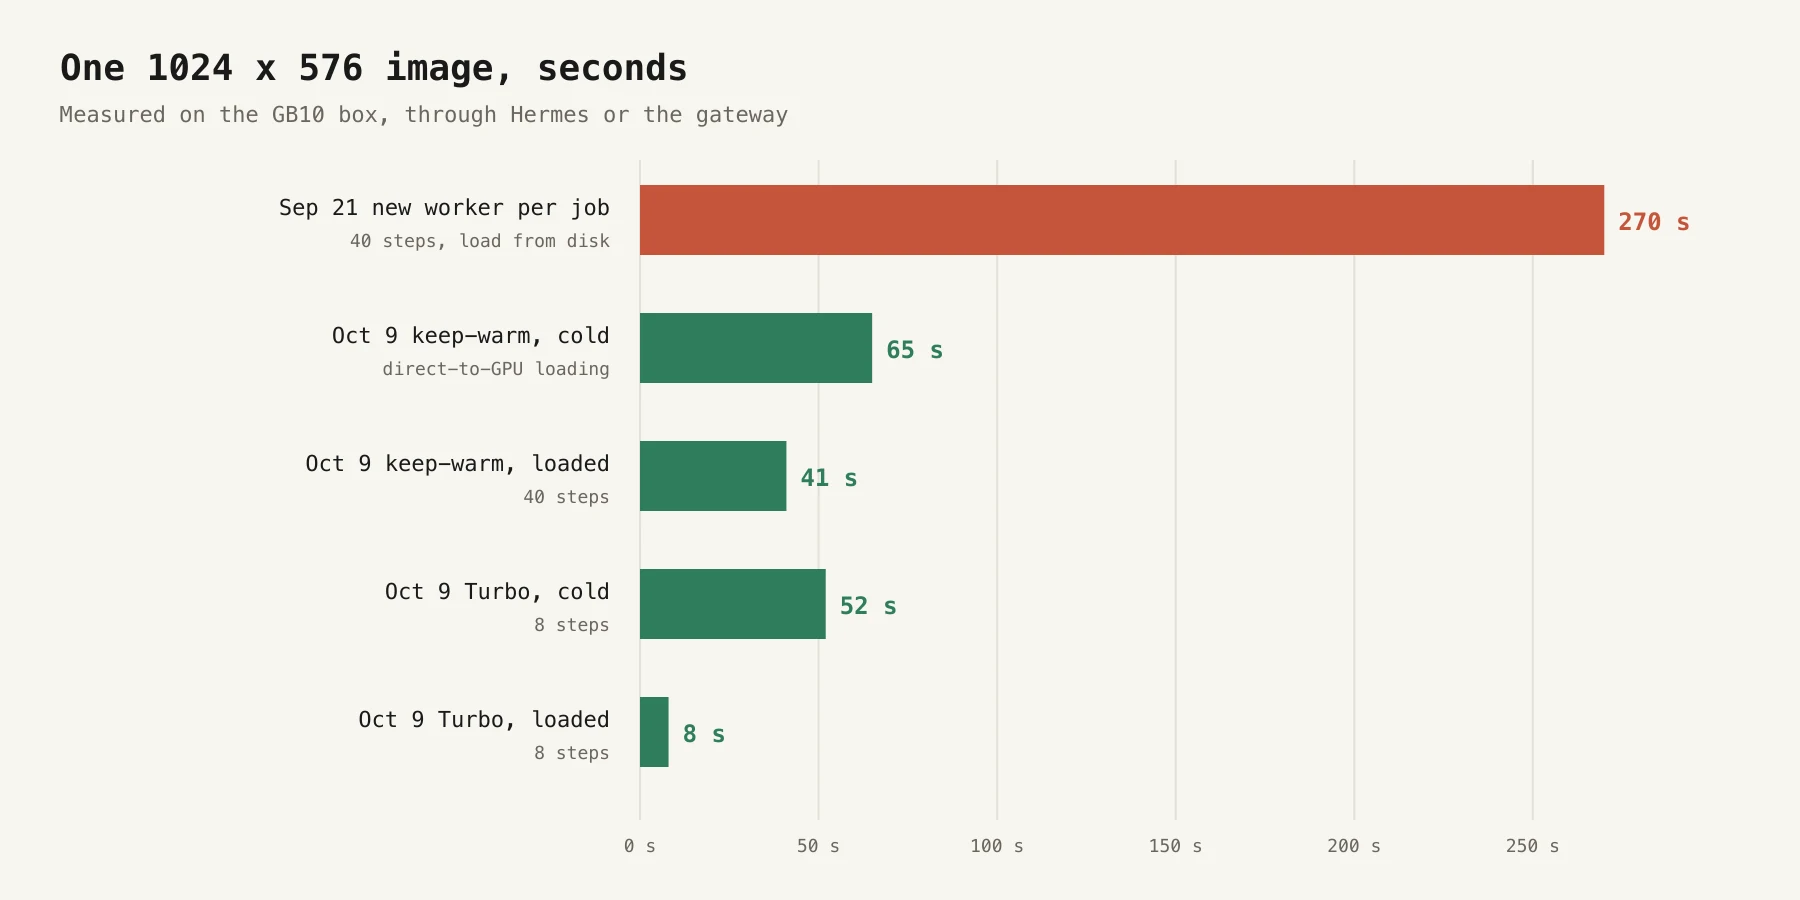 Sekunden pro Bild auf der GB10-Box, von September bis Oktober
Die erste funktionierende Version (21. September) hat für jedes Bild einen frischen Worker gestartet und für ein Bild mit 1024×576 270 Sekunden gebraucht. Davon waren nur 34 Sekunden Rechenzeit, der Rest war das Laden von 33 GB Gewichten.
Drei Änderungen:
- Modell geladen lassen, zehn Minuten nach der letzten Anfrage, und Gewichte direkt in den GPU-Speicher laden. Die Standardkopie der Bibliotheken aus memory-mapped Dateien lief auf dieser Box mit etwa 0,2 GB/s. Kalt: 65 s, warm: 41 s, mit pixelgleichem Ergebnis.
- Qwen-Image-2.1-Turbo mit 8 statt 40 Schritten: rund 8 Sekunden pro Bild, wenn es geladen ist. Text im Bild ("Willkommen im Hotel Alpenblick", "SKYLINE") war so gut wie beim vollen Modell, eher sauberer. Haut und Haare waren glatter und zeigten weniger natürliches Detail.
- Zwei Stufen in einem Worker. Turbo macht die Entwürfe. Gefällt mir einer, rendert das volle Modell ihn mit gleichem Prompt und Seed in 35 bis 75 Sekunden neu. Beide Checkpoints teilen sich einen bit-identischen Text-Encoder und VAE, also kommt für die zweite Stufe nur ein 14-GB-Transformer dazu. Den Entwurf stattdessen über den Edit-Modus zu verfeinern sah überarbeitet aus (HDR-Look, überschärft), deshalb gibt es diese Option nicht.
Der Preis: Das Bildmodell braucht in der Spitze rund 37 GiB, mit beiden Stufen 50 GiB. Solange es geladen ist, pausiert THINK und kommt danach automatisch zurück. FAST bleibt immer an.
Zwei ehrliche Grenzen. Kleiner Text in einer Szene (eine Kreidetafel-Speisekarte) ist nicht lesbar, und eine Bearbeitung wie "mach einen verschneiten Winterabend daraus" hat nur Himmel und Berge verändert. Außerdem steht Qwen-Image unter der Qwen Research License, die nur Forschung und Evaluierung erlaubt. Deshalb sind die Bilder in diesem Beitrag selbst gezeichnete Diagramme und nicht von der Box.
Was schiefging (und was geholfen hat)
Eine Agent-Schleife mit 83 Tool-Calls
Eine THINK-Sitzung machte 83 Tool-Calls in 14 Minuten. Sie durchsuchte immer wieder lokale Doku, hielt eine JavaScript-Eigenschaft für eine Website-Domain und nutzte nie das Tool zum Lesen von Webseiten, das sie hatte. Korrigieren half nicht. Gelöst hat es das Harness, nicht das Modell:
- Harte Stopps in den Loop-Guardrails von Hermes. Ein Replay desselben Vorfalls stoppt jetzt bei Call 27.
- Ein lokaler Hermes-Patch. Die Datei-Tools lehnen redundante Aufrufe ab, aber jede Ablehnung enthielt einen sich ändernden Zähler, also sah die Wiederholungserkennung nie zwei gleiche Ergebnisse. Jetzt muss das Modell die Ablehnung respektieren. Das Replay dieses zweiten Fehlers stoppt bei Call 9.
- Ein Gateway-Fix. Die Reasoning-Auswahl von Hermes schickt
minimal, das das Qwen-Template nicht kennt, und jede Anfrage kam mit HTTP 500 zurück. Das Gateway übersetzt die Stufen jetzt, bevor es die Obergrenze anwendet.
Zusätzliche Prompt-Anweisungen, andere Sampling-Werte, Reasoning-History-Echo und Non-Thinking-Modus habe ich auch probiert. Keins davon half durchgängig. Non-Thinking schaffte in meinem kleinen Test sogar 9/9 und scheiterte dann an einer echten Coding-Aufgabe, weil es endlos nach Testdateien suchte. Kurze Tests schmeicheln.
Drei Worker auf einem Modell mit zwei Slots
Ich habe THINK gebeten, mehrere Jahre meiner Garmin-Trainingsdaten auszuwerten. Es hat drei Sub-Agents gestartet, alle auf THINK, dazu den Haupt-Agent und eine Hintergrund-Review. THINK hat zwei Slots, der Schlüssel erlaubt vier parallele Anfragen. Die Folge: HTTP 429, 180-Sekunden-Timeouts und eine Freigabeprüfung, die selbst am Limit scheiterte. Dazu zwei Befunde:
- Nachdem seine Code-Ausführung abgelehnt wurde, schrieb ein Worker ein Skript und führte es stattdessen übers Terminal aus. Freigaben müssen über alle Tools hinweg gelten, nicht pro Tool.
- Ein Worker fragte
page=1bei einer API mit nullbasierten Seiten ab und übersprang so die ersten 200 Aktivitäten jedes Jahres. Die Summen sahen plausibel aus und waren falsch.
Die Lehre: Parallele Sub-Agents auf das begrenzen, was die Hardware wirklich bedient, und das Zusammenrechnen deterministischem Code überlassen, statt das Modell Datensätze in Skripte abschreiben zu lassen.
FAST nimmt Abkürzungen
In einem Agent-Test mit neun Aufgaben schaffte FAST 8/9 bei einem Median von 6 Sekunden, THINK 9/9 bei 34 Sekunden. FASTs Fehler: Es nahm den Umsatzsteuersatz aus einem Suchergebnis-Snippet und rechnete im Kopf. Jetzt zieht eine Runtime-Regel einen Entwurf, der ein Pflicht-Tool übersprungen hat, einmal zurück und sagt dem Modell, was fehlt. Die Aufgabe besteht jetzt 3/3. Automatisch nach fünf Tool-Calls an THINK zu eskalieren machte Recherche-Aufgaben 6× langsamer, ohne dass mehr Aufgaben bestanden wurden, deshalb ist das ausgeschaltet.
Ein zweiter Mac kommt dazu
"Funktioniert wie alles andere" heißt auch: Der Rest des Haushalts kann es nutzen. Als meine Frau Hermes auf ihrem Mac wollte, war die erste Version eine lange Setup-Anleitung per E-Mail, die Schlüssel absichtlich nicht dabei. Seitdem bekommt jedes Gerät seinen eigenen Gateway-Schlüssel aus einem kleinen Skript:
- ein Schlüssel pro Person oder Gerät, vier parallele Anfragen, jederzeit widerrufbar (HTTP 401 sofort nach dem Entfernen)
- heraus kommt ein Setup-Text zum Einfügen: Basis-URL, Schlüssel, Modelle, wie Bildanfragen funktionieren, und ein Selbsttest
- er geht per AirDrop raus, nie per E-Mail, und der Master-Schlüssel des Gateways verlässt die Box nie
Alle teilen sich dieselbe Kapazität. THINK bedient zwei Anfragen gleichzeitig und reiht den Rest ein, und während jemand Bilder generiert, pausiert THINK für alle. Zu zweit ist das kein Problem. Für ein Team von zehn Leuten würde man anders dimensionieren.
Und, wie gut ist es?
Mein ehrliches Fazit nach einem Monat: Das Ziel ist zum großen Teil erreicht. Schnelles und langsames Denken, Bilder, Sehen und Sprache stecken in einer Box hinter einer App, und sie wird benutzt wie jede andere App.
- FAST fühlt sich im Alltag an wie ein Cloud-Modell. Rund 65 tok/s bei Text und 80 bei Code, Tool-Runden in Sekunden, vier Leute parallel. Die meisten meiner Chats verlassen FAST nie.
- THINK ist gründlich und langsam. 15 tok/s bei Text sind für sorgfältige Antworten okay, für Smalltalk nicht. Für lange, unbeaufsichtigte Agent-Läufe nutze ich weiterhin ein Frontier-Modell aus der Cloud. Dass die lokalen Modelle über 50+ Schritte verlässlich sind, kann ich noch nicht behaupten.
- Bilder sind jetzt wirklich brauchbar. Entwürfe in acht Sekunden ändern, wie man damit arbeitet: Man iteriert, statt zu warten.
- Das Harness zählt mehr als das Modell. Guardrails, erzwungene Tool-Regeln, getrennte Lese/Schreib-Verbindungen und ehrliche Evals haben mehr Probleme gelöst als jeder Modellwechsel.
Als Nächstes kommen vertrauenswürdige Zertifikate im lokalen Netz, ein Recherche-Sub-Agent mit eigenem Kontext und der Schritt dahin, dass ein Unternehmen das als fertige Box anstecken kann, ohne dass ich sie von Hand konfiguriere.
Du willst so etwas für dein Unternehmen, mit Daten, die im Haus bleiben? Hier steht, wie ich lokale KI-Systeme aufsetze, oder schreib mir einfach.
Chris Perkles
KI-Beratung, Automatisierung und Schulungen aus Salzburg. Gründer von Skyline Medien und AgencyFlow — die eigene Agentur läuft heute auf einem Bruchteil der alten Ressourcen.