Semantische Suche über 44.000 Fotos auf Gratis-Postgres
Die Vektorsuche über die ganze Bibliothek sank von 8-16 Sekunden auf wenige hundert Millisekunden, während die Datenbank von 1.018 MB auf 358 MB schrumpfte. Alles im Gratis-Tarif von Supabase.
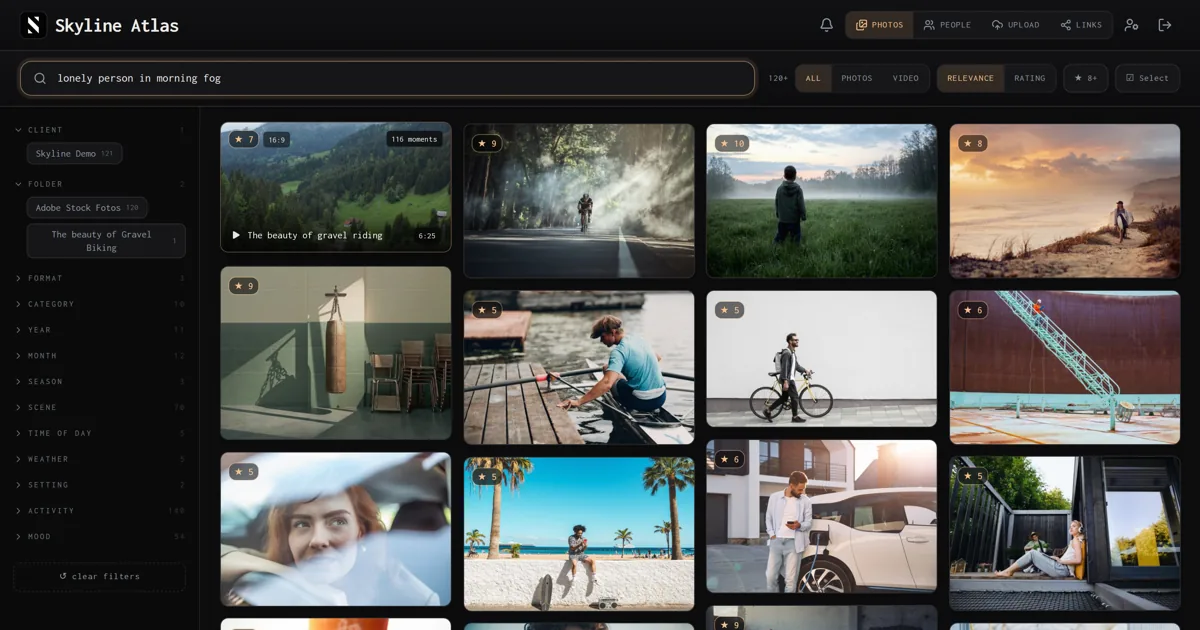
Ich baue eine Foto- und Videoplattform für Agenturen (intern: Skyline Atlas). Die Fotos werden lokal mit einem Vision-Language-Modell angereichert und dann in eine Supabase-Postgres-Datenbank gespiegelt, die das Web-Portal antreibt. Die Suche kombiniert Volltext, eine Text-Embedding-Spur (bge-m3, 1024 Dimensionen) und eine CLIP-Spur (768 Dimensionen).
Bei 15.000 Fotos lief das hervorragend. Dann habe ich mein privates Archiv importiert, rund 28.000 Fotos mehr, und die Suche ist stillschweigend kaputtgegangen.
So sieht es aus
Hier das Portal auf einer Demo-Bibliothek mit 120 Stockfotos. Die Anfrage wird als Embedding umgesetzt und nach Bedeutung gerankt (zusammen mit Volltext). Die Filter-Seitenleiste links zeigt die Facetten-Zähler, von denen weiter unten die Rede ist.
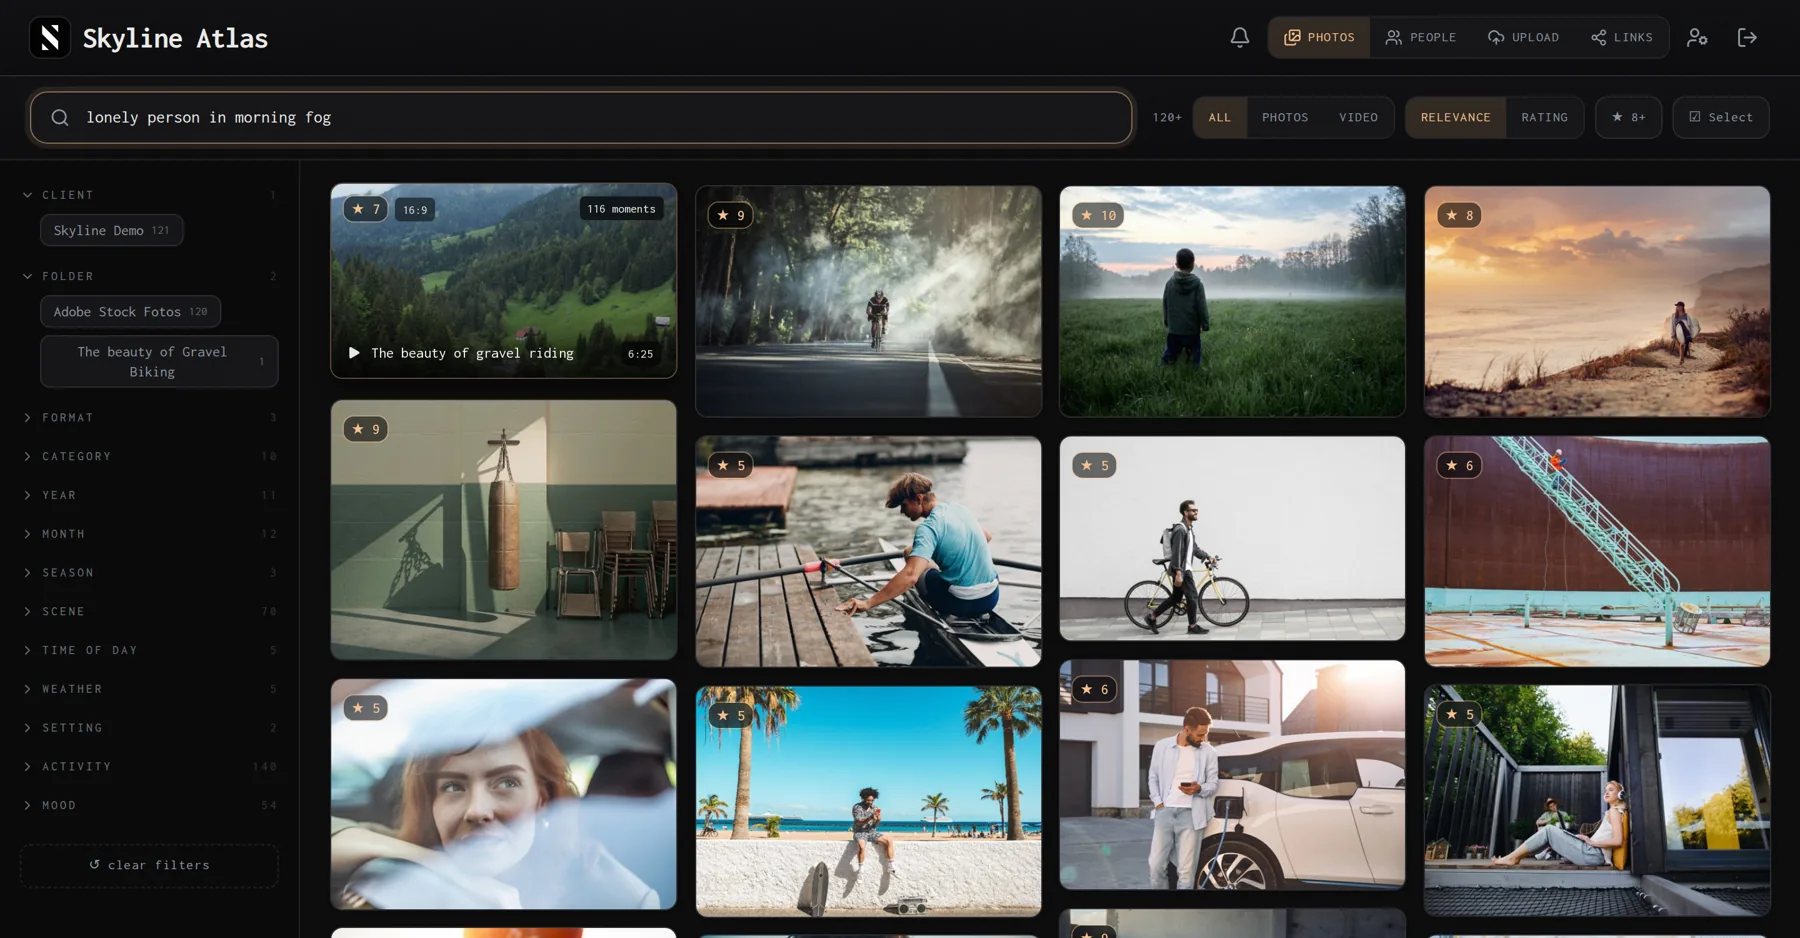 Skyline-Atlas-Portal bei der Suche nach "lonely person in morning fog"
Auch eine vagere, stimmungsbasierte Suche trifft: "cozy warm light, slow evening" liefert Decken, warme Innenräume und tiefstehende Sonne.
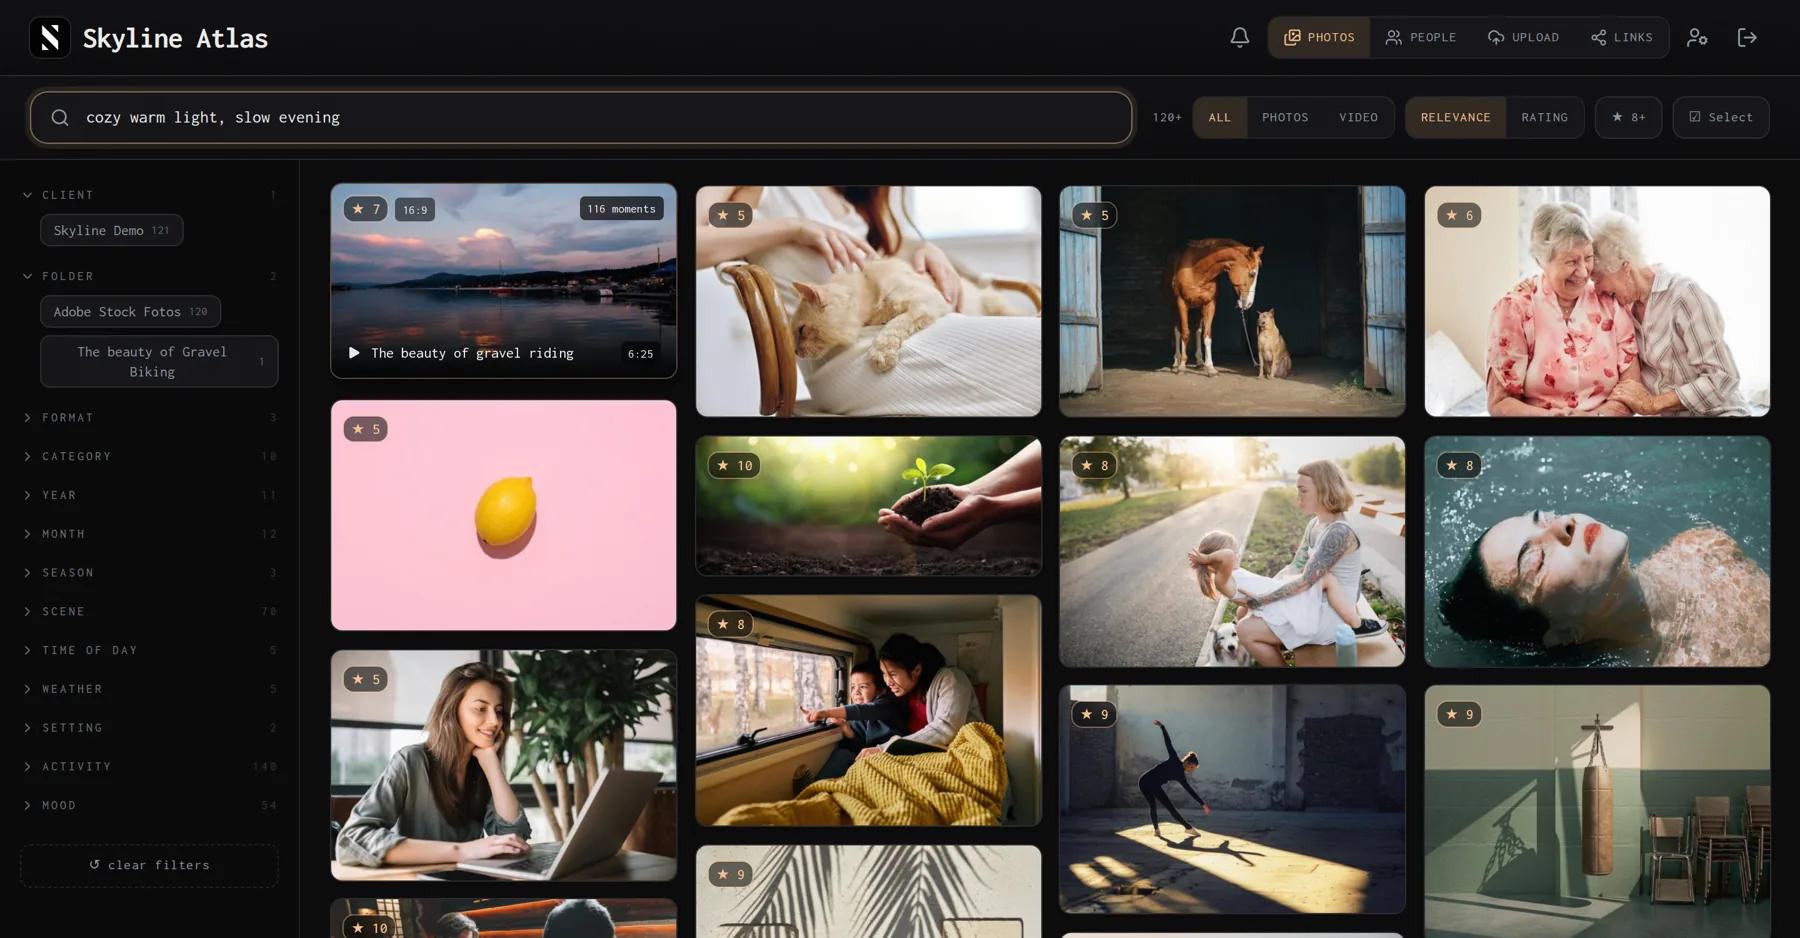 Skyline-Atlas-Portal bei der Suche nach "cozy warm light, slow evening"
Der Fehler, der nicht wie einer aussah
Die semantische Suche über die gesamte Bibliothek dauerte für Admin- und Staff-Logins 8 bis 16 Sekunden. Die Rolle authenticated hat ein statement_timeout von 8 s, die Abfrage wurde also abgebrochen. Das Portal hat das elegant abgefangen, und genau das war das Problem: Es zeigte stillschweigend nur Videos (eine separate, weiterhin schnelle Abfrage) und keine Fehlermeldung.
Mein stündlicher Smoke-Test blieb grün. Er lief nur mit FTS-verankerten Abfragen und als Superuser postgres. Daran waren zwei Dinge falsch, und dieselben zwei Dinge haben mich die ganze Zeit begleitet:
- Die Rolle zählt. RLS verändert den Abfrageplan komplett. Ein Test als
postgressagt nichts darüber, was ein Kunden-Login sieht. - Kalt und warm sind zwei verschiedene Datenbanken. Auf einer kleinen Instanz heißt Performance: "was passt in den Cache".
Der Smoke-Test führt jetzt eine semantische Suche über die ganze Bibliothek als Admin aus, mit 5 s Budget.
Das zweite Problem: die 500-MB-Grenze
Ich nutze den Gratis-Tarif von Supabase, der die Datenbank auf 500 MB begrenzt. Meine hatte 1.018 MB. Rund 800 MB davon waren Vektoren plus zwei Full-Precision-HNSW-Indizes (allein 516 MB). Ich war also schon über der Grenze, und jede Lösung mit einem zusätzlichen Index hätte es verschlimmert.
Die Arbeit hatte damit zwei Ziele, die gegeneinander ziehen: die Suche schneller machen und die Datenbank auf weniger als die Hälfte schrumpfen.
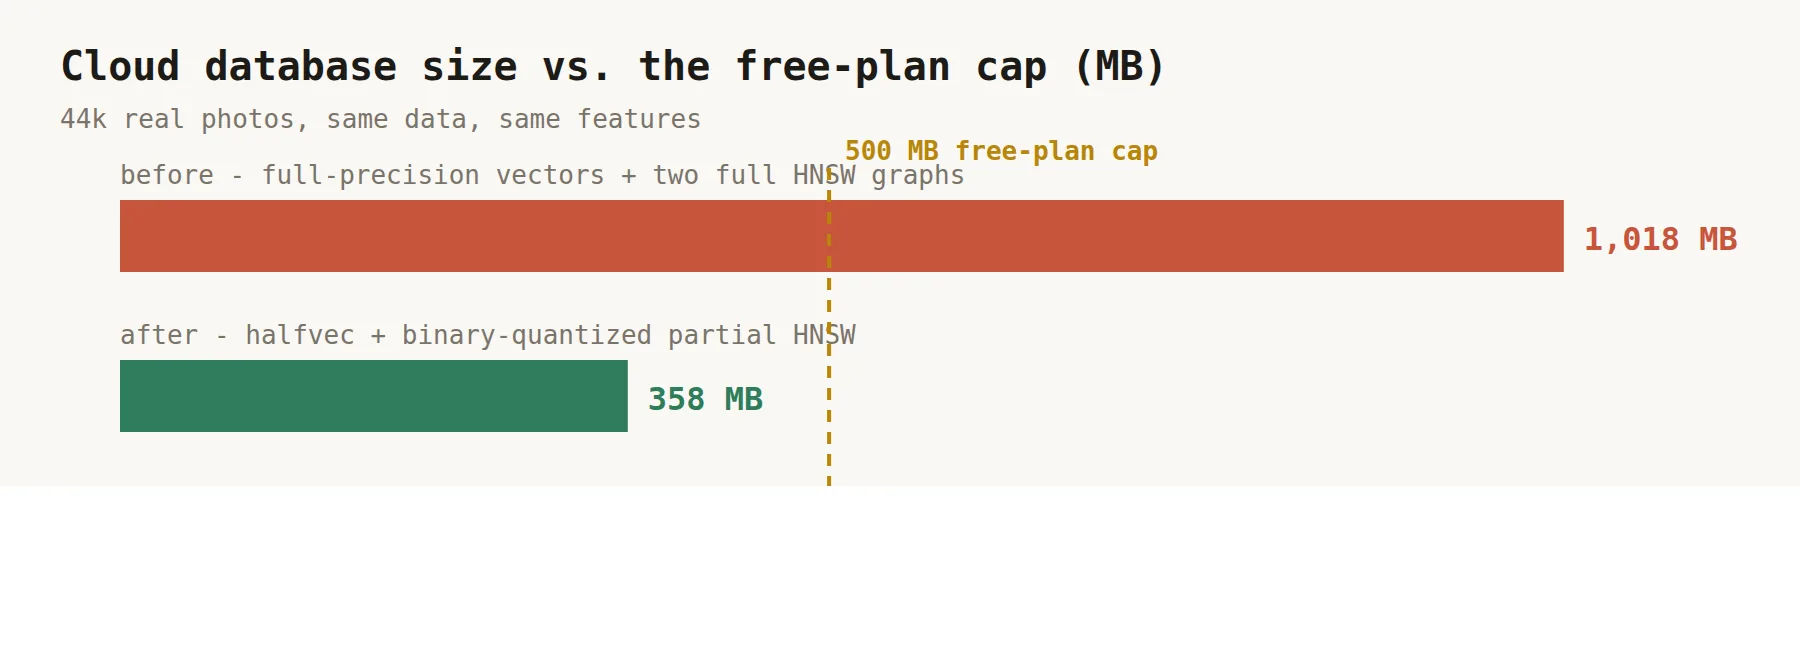 Datenbankgröße vorher und nachher
Was ich geändert habe
1. vector zu halfvec
Die Embeddings lagen als 32-Bit-Floats vor. Mit halfvec (16 Bit) halbiert sich der Speicher der Vektoren, und für Cosinus-Ranking ist der Präzisionsverlust nicht spürbar.
2. Binär quantisiertes HNSW mit exaktem Re-Rank
Die Full-Precision-HNSW-Graphen waren der größte Einzelposten. pgvector kann eine binär quantisierte Version des Vektors indizieren (1 Bit pro Dimension, verglichen per Hamming-Distanz):
create index photos_clip_bq on photos
  using hnsw ((binary_quantize(clip_vec)::bit(768)) bit_hamming_ops);
Die Hamming-Distanz nähert den Cosinus nur an. Deshalb liefert der Index eine überabgetastete Kandidatenliste (200 bis 400), die dann mit der exakten Distanz auf dem gespeicherten halfvec neu gerankt wird:
select c.id, c.clip_vec <=> q          -- exakte Distanz
from (
  select p.id, p.clip_vec
  from photos p
  where not p.deleted
  order by binary_quantize(p.clip_vec)::bit(768) <~> binary_quantize(q)
  limit p_n                            -- überabgetastet
) c;
Die Indizes schrumpften von rund 516 MB auf rund 36 MB. Außerdem bleiben sie auf einer winzigen Instanz im Cache, und das war wichtiger als die Größe auf der Platte. Bei meinen Testabfragen überlappten die Top 120 zu 116 bis 120 von 120 mit dem alten Ranking.
3. Den Planer nicht schlau sein lassen
Innerhalb der großen Ranking-CTE bevorzugte Postgres einen Hash-Semi-Join mit vollständiger Sortierung und entpackte dabei jeden sichtbaren Vektor (rund 10 s bei 15.000 Zeilen). Wenn die ANN-Abfrage in einer eigenen plpgsql-Funktion steckt, kann der Planer nichts anderes tun, als den Index zu durchlaufen.
Die Ranking-Funktion wählt jetzt den Pfad nach der Größe der sichtbaren Menge:
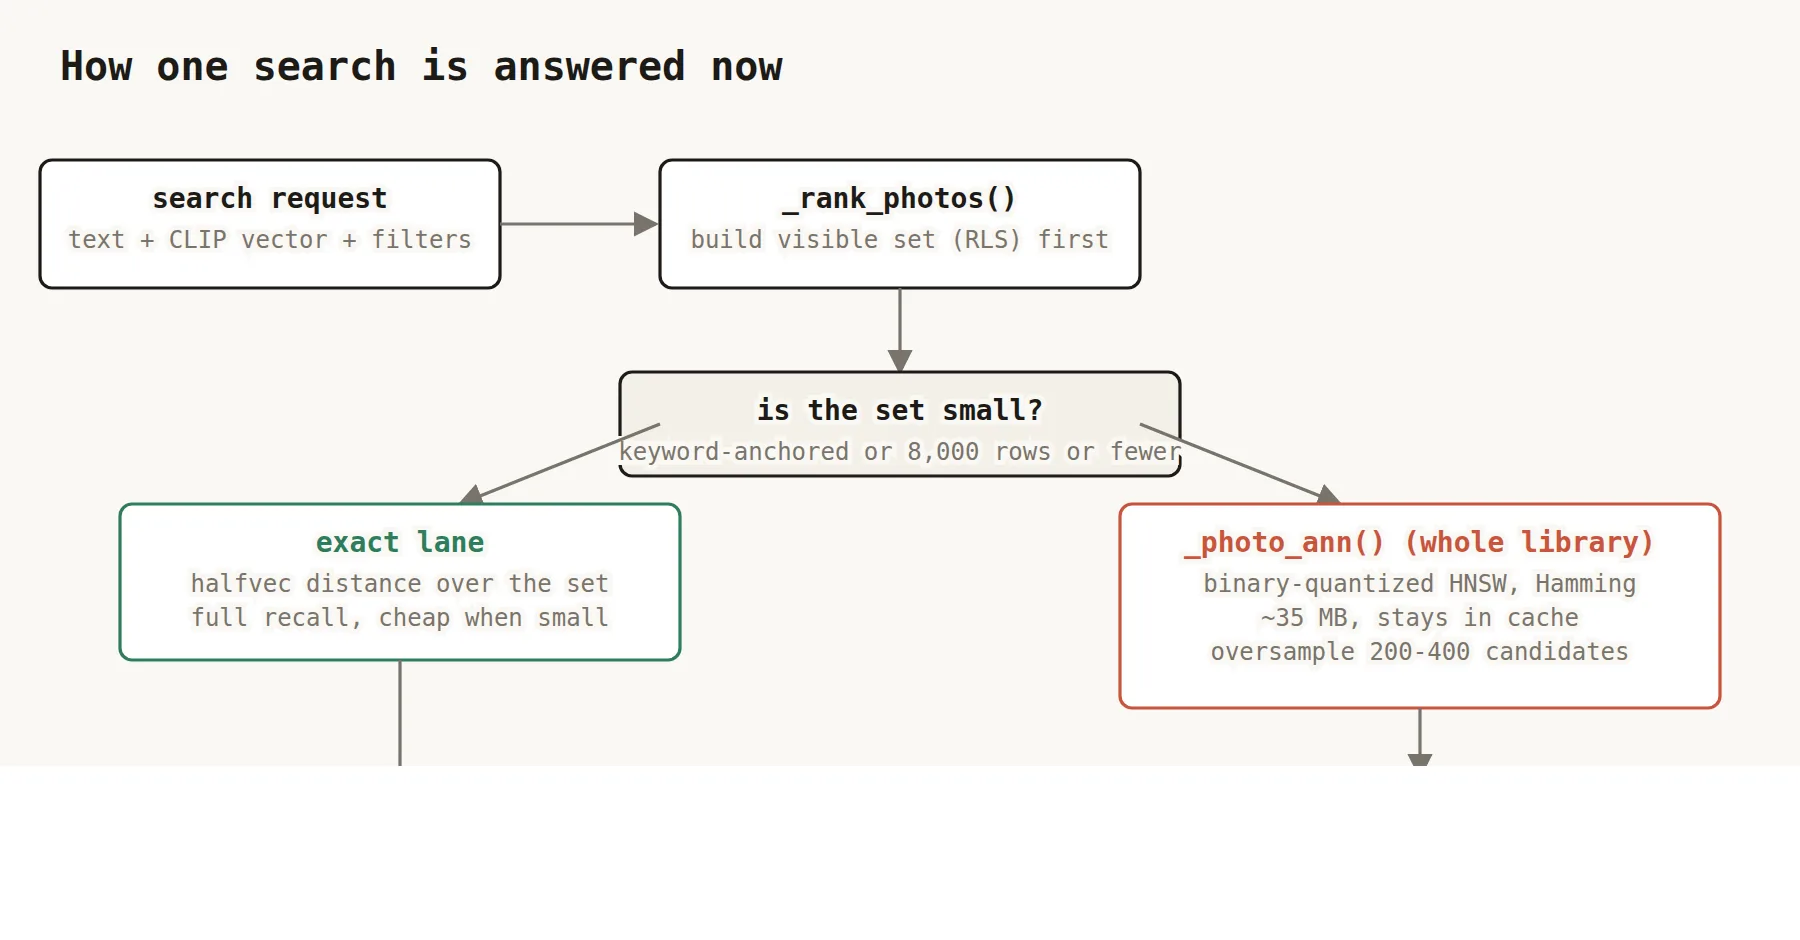 Wie eine Suche beantwortet wird
Ist die Abfrage durch ein Stichwort verankert oder die sichtbare Menge höchstens 8.000 Zeilen groß (jede Kundengalerie, jeder Shoot-Filter), wird exakt gerankt, mit vollem Recall. Nur große, unverankerte Abfragen, in der Praxis die Admin- und Staff-Suche über die ganze Bibliothek, laufen über den quantisierten Index.
4. Indizes nach Sichtbarkeit aufteilen
Das war die am wenigsten offensichtliche Änderung. Mit Row-Level-Security liefert HNSW auch Zeilen, die der Aufrufer nicht sehen darf, und jede davon kostet trotzdem einen Heap-Zugriff, bevor RLS sie verwirft. Mein privates Archiv machte den Großteil der Bibliothek aus und war für die meisten Nutzer unsichtbar, dominierte aber den Graph-Durchlauf.
Die Lösung war, die Indizes nach Sichtbarkeit zu partitionieren: eine denormalisierte Spalte is_private, per Trigger synchron gehalten, ein Partial-Index für öffentliche Zeilen und eigene Indizes pro Kunde ab 8.000 Fotos. RLS bleibt die Sicherheitsgrenze. Die Partition entscheidet nur, welcher Graph durchlaufen wird.
Der Beweis bei 500.000 Fotos
44.000 Fotos sind kein Skalierungstest. Also habe ich ein Labor gebaut: einen lokalen Postgres-Container in Form der Supabase-Micro-Instanz (gleiches pgvector, gleiches Schema, gleiche RLS, gleicher Speicher), gefüllt mit 500.000 synthetischen Fotos, geklont aus rund 5.000 echten Zeilen. Ein search-bench-Befehl fährt jeden Fall für jede Rolle.
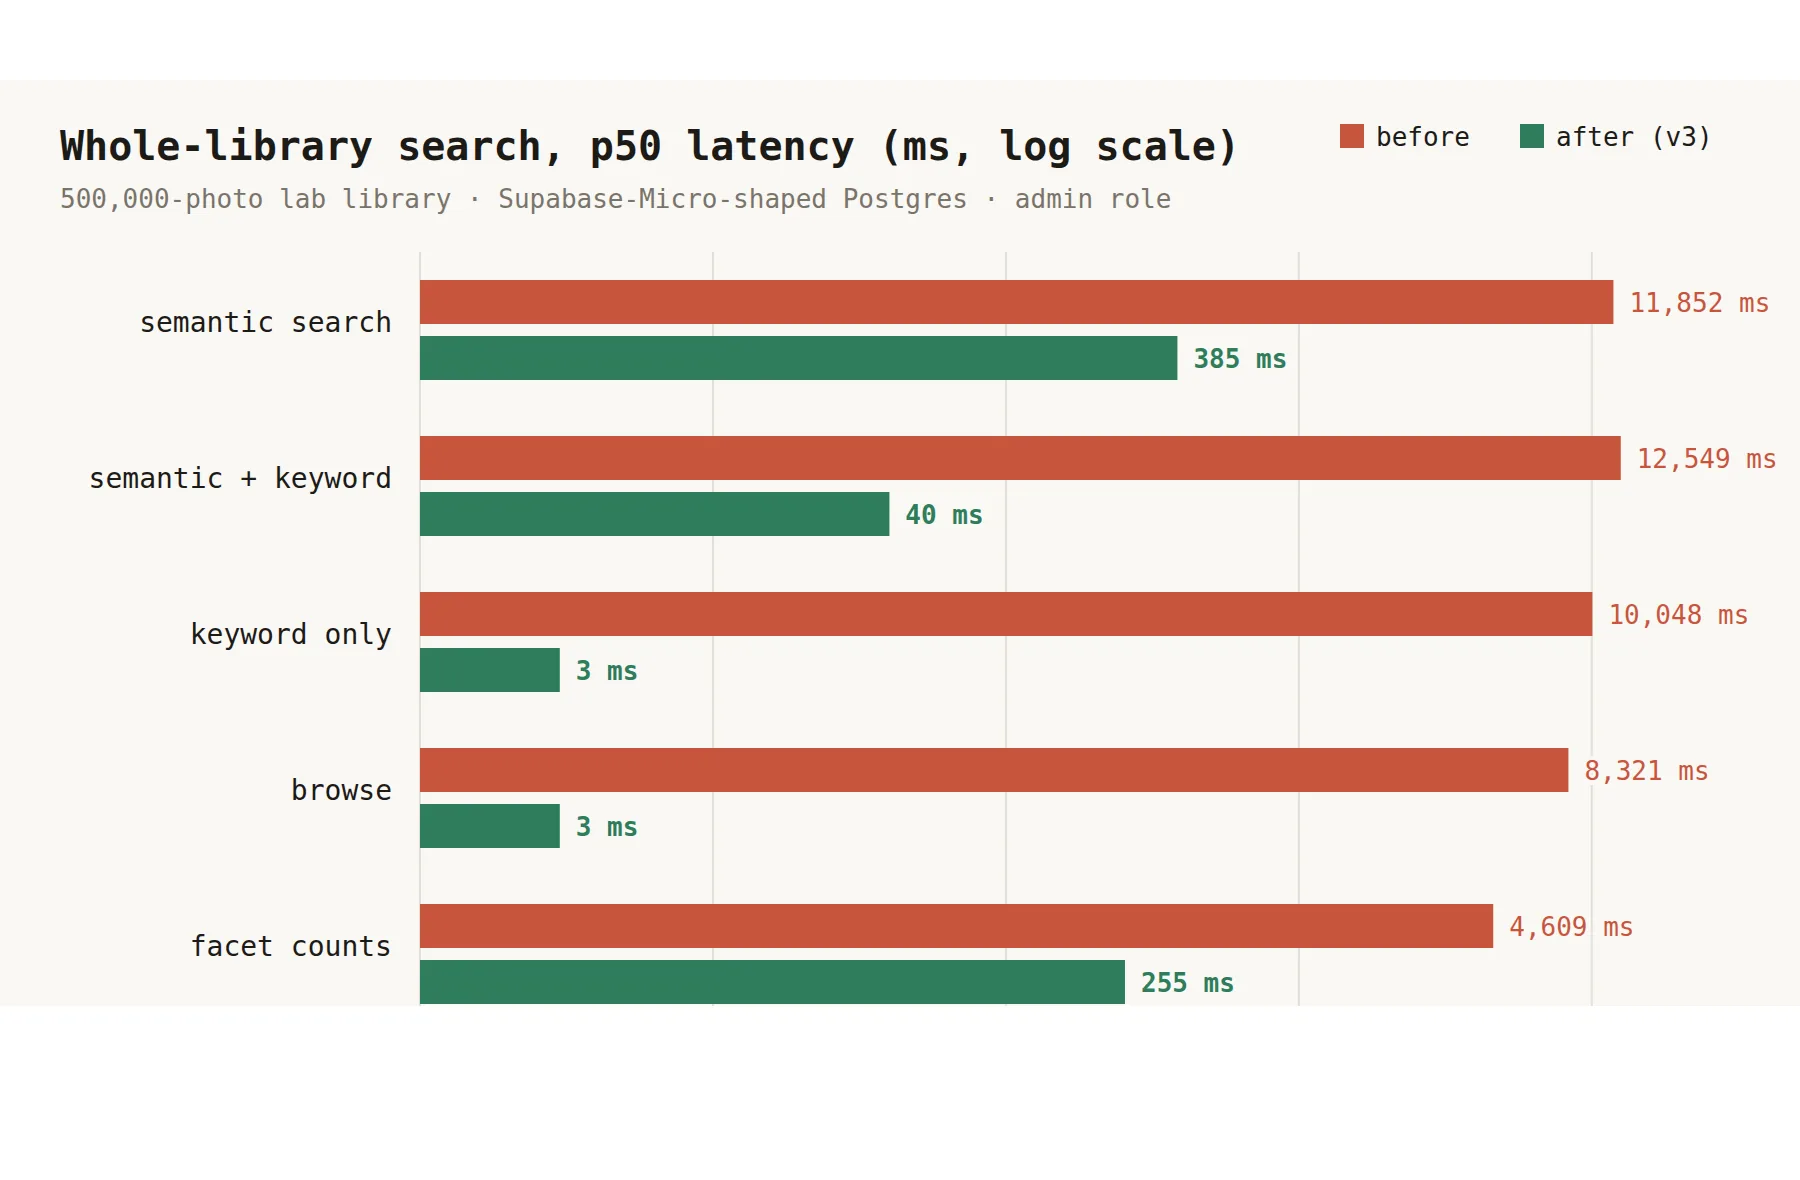 Latenz vorher und nachher bei 500k
| Fall (Admin, p50) | Vorher | Nachher |
|---|---|---|
| semantisch | 11.852 ms | 385 ms |
| semantisch + Stichwort | 12.549 ms | 40 ms |
| Stichwort | 10.048 ms | 3 ms |
| Browse | 8.321 ms | 3 ms |
| Facetten-Zähler | 4.609 ms | 255 ms |
Auf der echten Cloud-Datenbank (44.000 Fotos) brachten dieselben Änderungen die semantische Admin-Suche von etwa 560 ms auf 70 ms (p50) und die Facetten von 403 ms auf 61 ms. Der ursprüngliche 8-bis-16-s-Fall liegt jetzt bei 130 bis 400 ms.
Eine Einschränkung zu den Labor-Zahlen: Jede Beispielzeile existiert rund 100-mal mit fast identischen Vektoren und derselben Bildbeschreibung. Die Top-10-Überlappung zwischen Versionen ist deshalb verrauscht (willkürliche Reihenfolge unter den Klonen). Die Qualität habe ich gegen die exakte Ground Truth gemessen (echte k-NN-Distanz), nicht nur über die Überlappung. Der Recall war in jeder Persona gleich oder besser.
Was ich nur durch Ausprobieren gelernt habe
Das hat mich Stunden gekostet, hier als Liste:
- HNSW-Indizes vor dem Backfill löschen. Mit vorhandenen Indizes fügt jedes Nicht-HOT-
UPDATEin den Graphen ein. Mein Backfill war zäh, bis ich sie gelöscht und danach perCONCURRENTLYneu gebaut habe. DROP COLUMNgibt keinen Speicher frei. Dafür braucht esVACUUM FULL, das alle Indizes unter exklusivem Lock neu baut: 66 s ohne die Vektor-Indizes, 3 Minuten mit. Also vor dem Bau der Vektor-Indizes erledigen.col = any(<Array mit 44k Elementen>)als Index-Scan-Filter wird nicht gehasht. Das kostete 4,5 s. Stattdessen per Hash-Join gegen die Basismenge verbinden.- Ein gecachter generischer Plan kann viel langsamer sein als ein individueller. Eine PL/pgSQL-Facetten-Funktion brauchte 1,3 s wegen eines Nested Loops im generischen Plan.
set plan_cache_mode = force_custom_planan der Funktion hat es behoben.auto_explainlässt sich auf Supabase nicht laden, also habe ich es mitPREPAREplusplan_cache_modereproduziert. - Parallele Index-Builds laufen auf einer Micro-Instanz in den Speichermangel (Dynamic Shared Memory). Seriell bauen, mit
maintenance_work_mem = 64MB. - Massen-
UPDATEs blähen den Heap auf (etwa +65 MB für einen einzigen Boolean-Backfill). EinVACUUM FULLeinplanen. - Vorberechnen, was geht. Die Facetten-Zähler werden jetzt pro Kunde vorberechnet: Statement-Trigger markieren sie als veraltet, ein 5-Minuten-Timer aktualisiert sie. Im Gratis-Tarif gibt es kein
pg_cron, also übernimmt das ein systemd-Timer.
Was noch offen ist
- Die einfache semantische Suche im privaten Archiv braucht warm noch etwa 1 s und kann kalt langsam sein. 33.000 Zeilen passen nicht in den Cache der Instanz, die Zeit geht also in Heap-Zugriffe beim Re-Ranking der Kandidaten. Weniger Kandidaten oder eine kleinere Überabtastung könnten helfen.
- Ich liege nach der Metadaten-Stichwortsuche bei rund 436 MB von 500 MB. Das ist Platz für etwa 7.000 weitere Fotos, im Gratis-Tarif steckt also vielleicht noch ein Import. Die ehrliche Antwort ist der Pro-Tarif für 25 Dollar im Monat, und die Entscheidung dafür treffe ich lieber bewusst, als sie von einem Import treffen zu lassen.
Die allgemeine Lehre
Auf einem kleinen Postgres optimiert man weniger Abfragen als vielmehr das, was im Speicher sein muss. Kleinere Vektoren, kleinere Indizes und Indizes, die zur Sichtbarkeit passen, wirken alle aus demselben Grund. Miss kalt und warm, und miss als jede Rolle, die du hast, denn RLS macht daraus verschiedene Datenbanken.
Chris Perkles
KI-Beratung, Automatisierung und Schulungen aus Salzburg. Gründer von Skyline Medien und AgencyFlow — die eigene Agentur läuft heute auf einem Bruchteil der alten Ressourcen.